
AI 기술
NER의 현재와 미래: 02. 모델 구조와 데이터 셋 현황
이 글은 레터 AI의 이전 이름인 레터웍스(LETR WORKS)로 작성되었습니다.
이 포스팅은 2023년 현재 최신 동향에 맞게 업데이트되었으니 아래 글을 참고해주시기 바랍니다.
NER의 현재와 미래 Ver.2: 한국어 NER 데이터 셋 총정리
<NER의 현재와 미래> 시리즈의 두 번째 주제인 이번 콘텐츠는 ‘NER의 모델 구조와 데이터 셋’에 대한 내용을 준비했습니다. 첫 번째 주제 ‘개념부터 다양한 접근법까지’에서 이어지는 내용이니 아직 확인하지 못한 분은 먼저 읽어보실 것을 추천드립니다.
* NER의 현재와 미래: 01. 개념부터 다양한 접근법까지 보러가기
NER의 모델 구조
논문 ‘A Survey on Deep Learning for Named EntityRecognition’에 따르면, NER 모델의 구조는 아래 그림과 같이 세 단계의 프로세스로 나눌 수 있습니다.
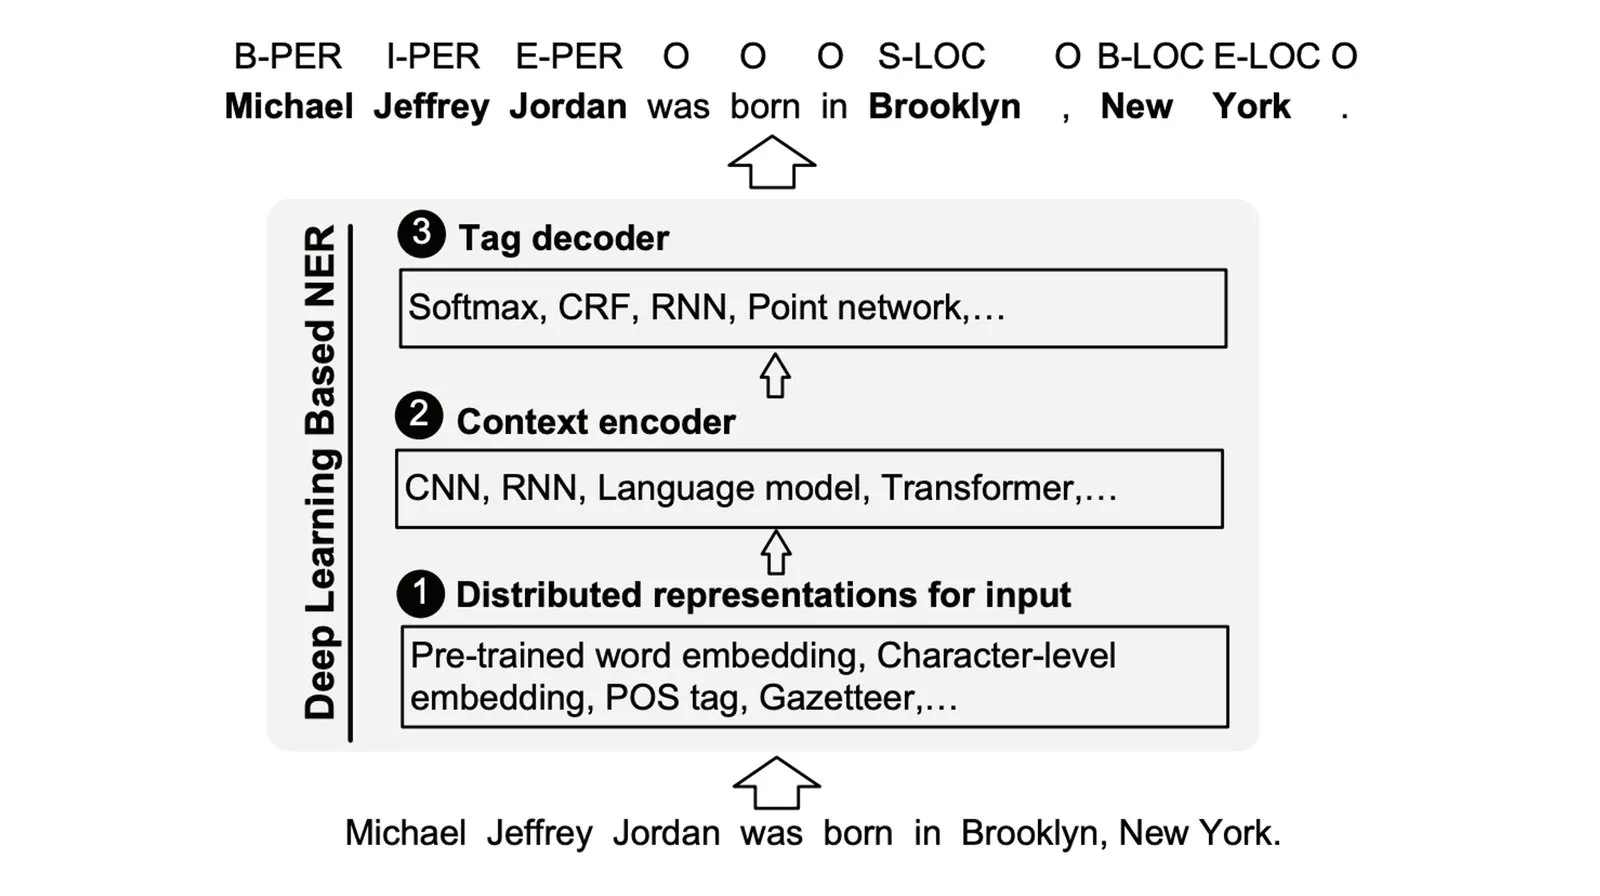
* 표 출처: https://arxiv.org/pdf/1812.09449.pdf
(1) Distributed Representations for Input*
인풋 데이터를 벡터 등으로 표현하는 층으로 Pre-trained word embedding, Character-level embedding, POS* tag,Gazetteer 등을 이용합니다.
(2) Context Encoder
문맥 정보를 인코딩하는 층으로 CNN*, RNN*, Language model*, Transformer* 등의 모델을 이용합니다.
(3) Tag Decoder
태그 정보를 디코딩하는 층으로 Softmax, CRF*, RNN, Point network 등의 모델을 이용합니다.
다만 모든 모델들이 위의 구조를 엄격히 따르는 것은 아닙니다. 특히 딥러닝 쪽 모델들은 End to end로 작업이 이루어지기 때문에 단계가 명확히 나뉘지 않는 경우도 있습니다. 하지만 전통적인 접근법을 포함한다면 대체로 위와 같이 세 단계로 나누어 생각할 수 있습니다.
* Distributed Representations forInput: 입력에 대한 분산 표현
* POS(part-of-speech, 품사), https://en.wikipedia.org/wiki/Part_of_speech
* CNN(Convolutional Neural Networks), https://en.wikipedia.org/wiki/Convolutional_neural_network
* RNN(Recurrent neural network), https://en.wikipedia.org/wiki/Recurrent_neural_network
* Language model, https://en.wikipedia.org/wiki/Language_model
* Transformer, [https://en.wikipedia.org/wiki/Transformer_(machine_learning_model)](https://en.wikipedia.org/wiki/Transformer_(machine_learning_model%29)
* CRF(Conditional random field), https://en.wikipedia.org/wiki/Conditional_random_field
NER 관련 라이브러리 현황 및 성능 평가
현재 한국어에만 특화된 공식적인 NER 라이브러리는 찾기 어려우며, 대부분 다국어로 학습된 모델에서 한국어를 찾을 수 있습니다. 각 라이브러리의 특성은 다음과 같습니다.
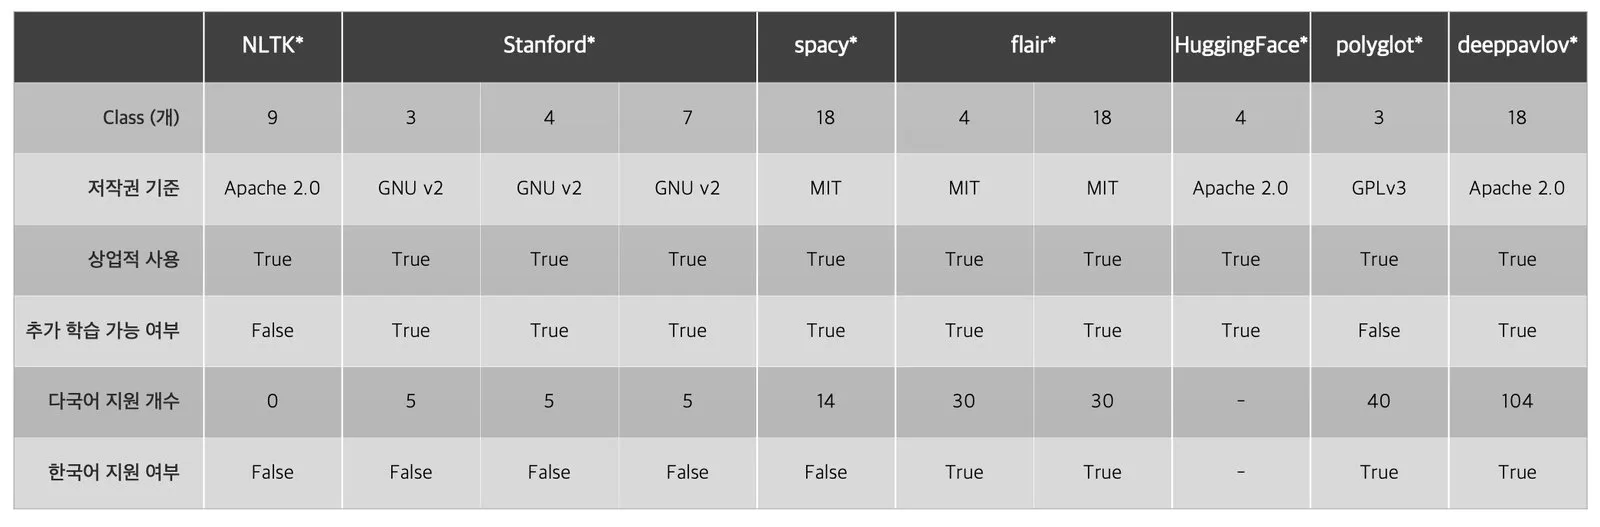
이어서 Kaggle<em>에서 배포된 데이터 셋</em>으로도 평가를 진행해봤습니다. 데이터 셋의 클래스 개수와 라이브러리의 클래스 개수가 모두 다르기 때문에 각 클래스를 데이터 셋의 클래스와 매칭시켜 주는 작업이 수반되었고, 이 과정에서 기준 데이터 셋보다 많은 클래스를 분류해 낼 수 있는 라이브러리일수록 Precision이 떨어지는 현상이 발생함을 확인했습니다. 따라서 NER 성능의 판단 기준으로는 통상적으로 사용되는 Precision과 이를 이용한 F1-score는 제외하고, 재현율과 걸린 시간만으로 라이브러리의 성능을 판단하게 됐습니다. 그 결과는 다음과 같습니다.
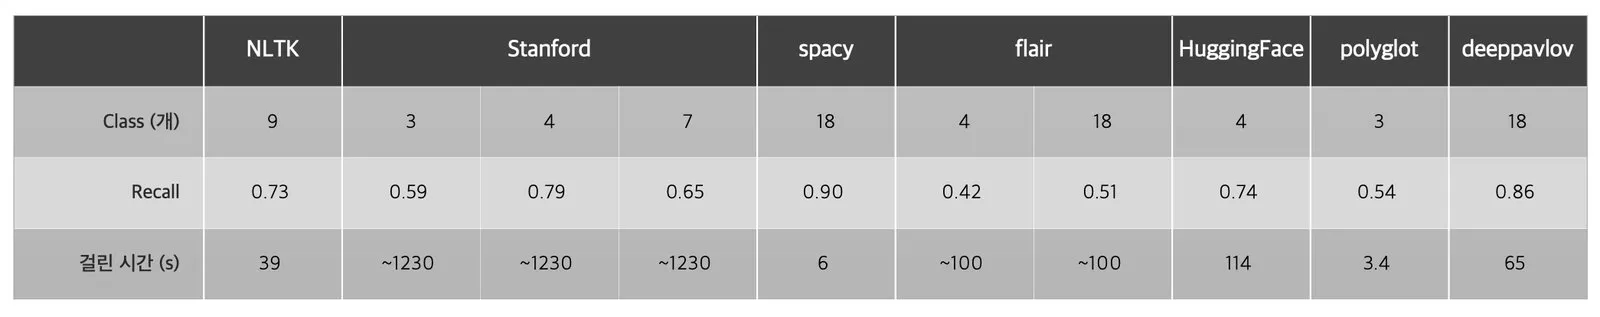
(1,000개 문장 기준) 걸린 시간에서 Stanford NER Tagger가 현저하게 낮은 성능을 보이며, Recall 면에서는 flair와 polyglot이 현저하게 낮은 성능을 보임을 확인할 수 있습니다.
* Kaggle, https://en.wikipedia.org/wiki/Kaggle
* https://www.kaggle.com/abhinavwalia95/entity-annotated-corpus
* NLTK(Natural Language Toolkit), https://en.wikipedia.org/wiki/Natural_Language_Toolkit
* Stanford, https://nlp.stanford.edu/software/CRF-NER.html#Models
* spaCy, https://en.wikipedia.org/wiki/SpaCy
* flair, https://github.com/flairNLP/flair
* Hugging Face, https://huggingface.co/datasets
* polyglot, https://polyglot.readthedocs.io/en/latest/#
* deppavlov, https://github.com/deepmipt/DeepPavlov
대표적인 영어 NER 데이터 셋
(1) CoNLL 2003 (Sang and Meulder,2003)*
: 저작권 정책 - DUA
: 1,393개의 영어뉴스 기사(스포츠 관련이 많음)
: 4종류의 Annotated* Entities – { LOC(location),ORG(organization), PER(person), MISC (miscellaneous) }
* CoNLL 2003, https://www.clips.uantwerpen.be/conll2003/ner/
* Annotated: <책 등이> 주석[주해]이 달린
(2) OntoNotes 5.0 (Weischedel etal., 2013)*
: 저작권 – LDC
: 데이터의 종류및 개수는 아래와 같습니다.
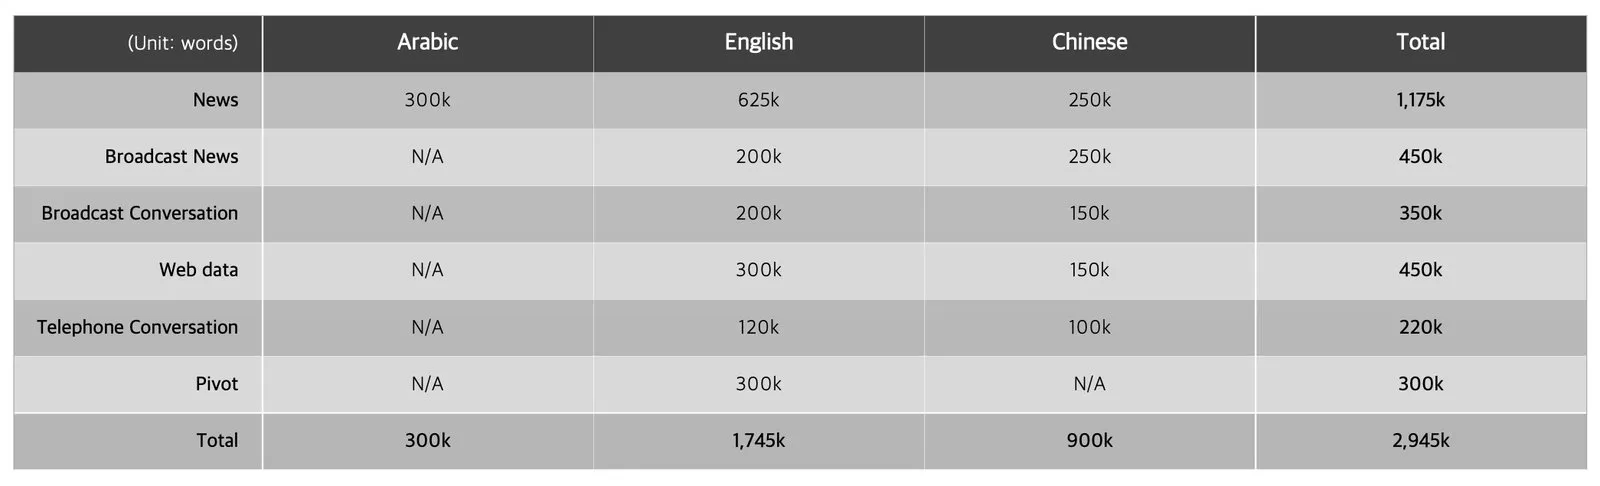
* OntoNotes 5.0, https://catalog.ldc.upenn.edu/LDC2013T19
* Pivot: Old Testament and New Testment text(구약성서 및 신약성서 텍스트)
* 표 출처: https://catalog.ldc.upenn.edu/LDC2013T19
: 18종류의 Annotated Entities
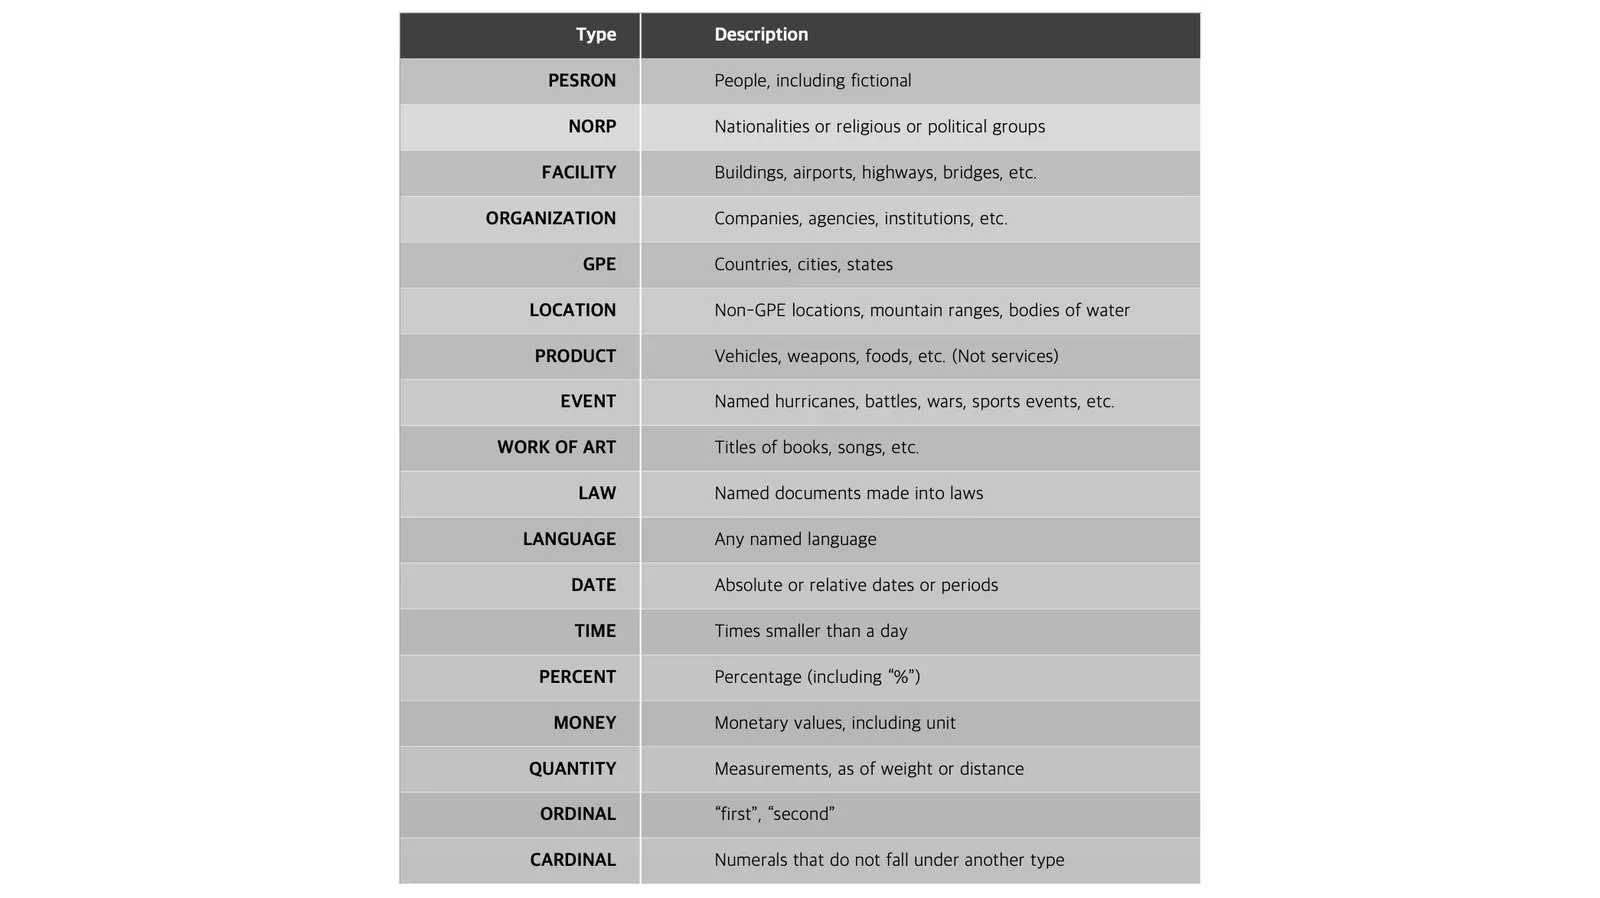
* 표 출처 : https://catalog.ldc.upenn.edu/docs/LDC2013T19/OntoNotes-Release-5.0.pdf
(3) MUC-6 (Grishman and Sundheim,1996)
: 저작권 정책 – LDC
: 월 스트리스 저널에서 추출한 뉴스기사
: 3 종류의 Annotated Entities – { PER, LOC, ORG }
* MUC-6, https://cs.nyu.edu/~grishman/muc6.html
(4) WNUT 17 : Emerging and Rareentity recognition (Derczynski et al., 2016)
: 저작권 정책 – CC-BY 4.0
: Social media ( YouTube comments,Stack Overflow responses Twitter text and Reddit comments )
: 6 종류의 Annotated Entities – ( Person,Location, Group, Creative word, Corporation, Product )
* WNUT 17, https://noisy-text.github.io/2017/emerging-rare-entities.html
대표적인 한국어 NER 데이터 셋
한국의 NER 데이터는 그 수가 매우 부족한 상황입니다. 현재 공개된 한국어 NER 데이터 셋은 총 세 가지이며, 모두 상업적 이용은 제한되어있습니다.
(1) 국립국어원 NER 데이터 셋
:총 3,555개 문장
:BIO 태깅 시스템 사용
:5종류의 Annotated Entities – { 장소(LC), 날짜(DT), 기관(OG), 시간(TI), 인물(PS) }
* 국립국어원 모두의 말뭉치, https://corpus.korean.go.kr
(2) 한국해양대학교 자연어처리 연구실 NER 데이터 셋
:총 23,964개 문장
:BIO 태깅 시스템 사용
:10 종류의 Annotated Entities – { 인물(PER), 기관(ORG), 지명(LOC), 기타(POH), 날짜(DAT), 시간(TIM), 기간(DUR), 통화(MNY), 비율(PNT), 기타 수량표현(NOH) }
* 한국해양대학교 자연언어처리 연구실 깃허브, https://github.com/kmounlp
(3) NAVER NLP Challenge 2018
:총 82, 393개문장
:BIO 태깅 시스템 사용
: 14 종류의 AnnotatedEntities – { 인물(PER), 학문분야(FLD), 인공물(AFW), 기관및 단체(ORG), 지역명(LOC), 문명 및문화(CVL), 날짜(DAT), 시간(TIM), 숫자(NUM), 사건사고 및 행사(EVT), 동물(ANM), 식물(PLT), 금속/암석/화학물질(MAT), 의학용어/IT관련 용어(TRM) }
* 네이버 NLP Challenge 깃허브, https://github.com/naver/nlp-challenge
지금까지 ‘NER의 현재와 미래’에 대한 연재의 두 번째 주제인 “모델 구조와 데이터 셋 현황”이었습니다. 이 시리즈는 곧 세 번째 주제 ‘앞으로의 개발 방향과 목표’로 이어지게 됩니다.
NER의 현재와 미래
NER의 현재와 미래: 01. 개념부터 다양한 접근법까지
NER의 현재와 미래: 02. 모델 구조와 데이터 셋 현황
NER의 현재와 미래: 03. 앞으로의 개발 방향과 목표
🚀데이터 인텔리전스 플랫폼 ‘레터웍스’ 지금 바로 경험해보세요.
• 노트의 내용을 실제로 이용해 보세요! (한 달 무료 이용 가능 🎉)
• AI 기술이 어떻게 적용되는지 궁금한가요? (POC 샘플 신청하기 💌)